Widoczność w AI · 15 czerwca 2026
Audyt AEO naszej własnej strony: co było nie tak i co zmieniliśmy
TL;DR
Aventium to agencja AI dla polskich MŚP, która pomaga firmom być widocznymi w odpowiedziach ChatGPT, Gemini i Perplexity. Gdy sprawdziliśmy własną stronę naszym audytem AI, dostała 12 na 92 punkty: boty AI widziały niemal pustą stronę. Oto co naprawiliśmy i czego to uczy o Twojej witrynie.
Co się stało: nasza własna strona dostała 12/92 w naszym audycie
Zrobiliśmy własny audyt gotowości na AI (AEO) dla aventium.ai i wynik nas zawstydził: 12 na 92 możliwe punkty. Powód był jeden i krytyczny: treść strony w ogóle nie docierała do botów AI.
Strona była zbudowana w Lovable, narzędziu AI do „vibe-codingu", które generuje aplikacje w React (renderowanie po stronie przeglądarki). I tu ważna rzecz: Lovable znamy, lubimy i do dziś budujemy w nim nasze aplikacje. Świadomie chcieliśmy postawić własną stronę „po nowemu", z AI, zamiast klasycznie. I pod względem wyglądu wyszło świetnie: nowocześnie, szybko. Problem w tym, że nowoczesny wygląd i widoczność dla AI to dwie różne sprawy. Kiedy obejrzeliśmy źródło strony tak, jak widzi je crawler AI (bez JavaScriptu), treści nie było. Ani nagłówków, ani opisów usług. Dla bota nasza strona praktycznie nie istniała.
Dlaczego strona w React jest dla AI prawie pusta?
Bo większość crawlerów AI nie uruchamia JavaScriptu: pobierają surowy HTML i na tym kończą. Jeśli treść powstaje dopiero w przeglądarce, dzięki JS, bot widzi pusty szkielet.
Strony w React, Vue czy Angular działają tak: serwer wysyła do przeglądarki niemal pusty plik HTML plus duży plik JavaScript, a dopiero ten JavaScript „buduje" w przeglądarce widoczną treść. Tradycyjny i AI-owy crawler dostają ten sam pusty start: różni się to, co z nim robią. Analiza Vercel i MERJ na ponad 500 milionach pobrań GPTBota (crawlera OpenAI) nie wykazała ani jednego wykonania JavaScriptu; ten sam wzorzec dotyczy ClaudeBota i PerplexityBota. Wyjątkiem jest Googlebot, który JS renderuje. Dlatego strona w React potrafi świetnie radzić sobie w Google, a jednocześnie być pusta dla ChatGPT, Claude i Perplexity.
To nie złośliwość twórców tych systemów. Renderowanie JavaScriptu jest kosztowne obliczeniowo, a crawlery AI działają na ogromną skalę (sam GPTBot to setki milionów żądań miesięcznie), więc po prostu pobierają surowy HTML, żeby oszczędzić zasoby i czas.
Błąd krytyczny: treść, której bot AI w ogóle nie widzi
Żeby sprawdzić, co widzi bot, nie potrzebujesz specjalnego narzędzia: otwórz źródło strony (Ctrl+U lub Cmd+U) i poszukaj swojego tekstu. Jeśli zamiast treści jest pusty kontener i tag script, to dokładnie to dostaje crawler AI.
W naszym przypadku źródło strony wyglądało tak, jak w każdej aplikacji React renderowanej po stronie klienta:
<div id="root"></div>
<script src="/assets/index-abc123.js"></script>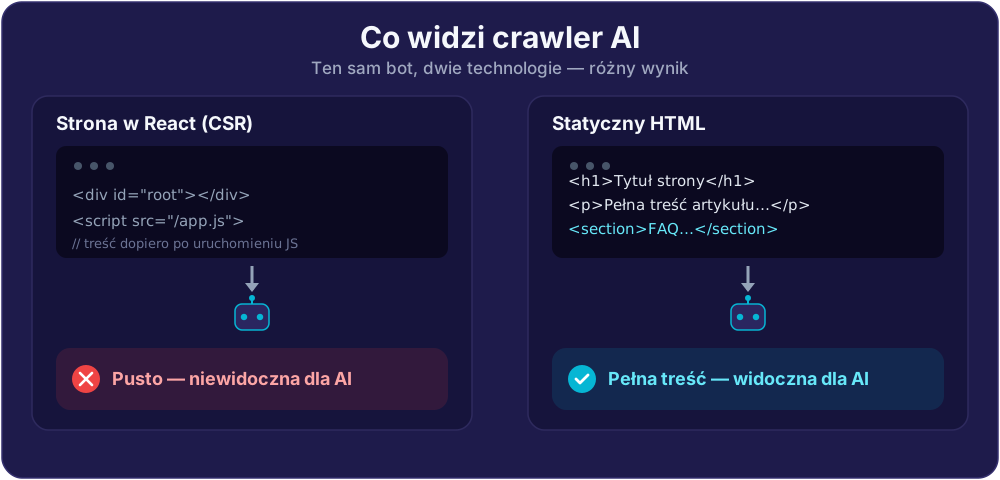
Pusty kontener i instrukcja: „uruchom JavaScript, żeby zobaczyć stronę". Crawler tego nie robi: pobiera ten HTML, nie znajduje treści, idzie dalej i nie wraca. To był nasz błąd numer jeden. I jednocześnie najczęstszy, jaki widzimy u innych firm: strona indeksuje się w Google (bo Googlebot renderuje JS), więc wszystko wygląda na sprawne, a dla AI jest niewidoczna.
Co zmieniliśmy: powrót do statycznego HTML (i dlaczego nie framework dla strony marketingowej)
Przepisaliśmy stronę na czysty, statyczny HTML i CSS, z minimalnym JavaScriptem, i postawiliśmy ją na Cloudflare Pages. Bez frameworka frontendowego.
Powód jest pragmatyczny: strona marketingowa agencji to kilkanaście podstron, których treść zmienia się rzadko. React, Vue czy Next.js to świetne narzędzia do budowania aplikacji webowych. Do strony „o nas, usługi, kontakt" są przerostem formy nad treścią, który kosztuje widoczność. (Dlatego nasze własne aplikacje dalej żyją w React: tam renderowanie po stronie klienta jest w porządku. Problem dotyczy stron treściowych, które mają być cytowane.)
Cała przebudowa zajęła nam około trzech tygodni w maju 2026, pracując po kilka godzin dziennie, obok prowadzenia firmy; samo przepięcie domeny zrobiliśmy pod koniec maja. Efekt był natychmiastowy: crawler pobierający stronę bez JavaScriptu widzi teraz pełną treść (nagłówki, opisy usług, sekcję FAQ, dane kontaktowe) w czystym HTML.
Jeśli nie chcesz rezygnować z frameworka, masz dwie drogi: SSR (renderowanie po stronie serwera) lub SSG (generowanie statycznego HTML). Więcej o tym w sekcji FAQ poniżej.
Porządki, które zrobiliśmy po drodze: schema, nagłówki, TL;DR, FAQ
Migracja techniczna to był główny ruch, ale przy okazji naprawiliśmy cztery rzeczy, które i tak ułatwiają AI zrozumienie i cytowanie strony:
- Dane strukturalne (schema.org). Metadane, które mówią botowi nie tylko co jest na stronie, ale czym ta strona jest. Bez nich bot zgaduje; ze schema wie.
- Struktura nagłówków. Jeden H1 na podstronę i logicznie zagnieżdżone H2/H3. Dla bota nagłówki to mapa strony.
- TL;DR pod H1. Krótkie streszczenie (40–50 słów) odpowiadające: czym jest ta strona i dla kogo. Systemy AI często cytują właśnie ten zwięzły, samodzielny fragment.
- Sekcja FAQ w czystym HTML. Jeden z najczęściej cytowanych formatów: gotowa odpowiedź na konkretne pytanie to gotowy materiał do wstawienia w odpowiedź chatbota.
Więcej o tym, jak robimy to u klientów, znajdziesz na stronie o widoczności w AI.
Efekt: z 12/92 do strony czytelnej dla AI
Po migracji ten sam crawler (bez JavaScriptu) widzi pełną treść strony, a wynik naszego audytu ruszył z miejsca 12/92.
To nie efekt zmiany jednej rzeczy. To usunięcie fundamentalnej bariery technicznej, która blokowała dostęp do treści, plus kilka poprawek, które tę treść ułatwiły zrozumieć i zacytować.
Warto rozumieć, dlaczego AI w ogóle cytuje strony. Systemy takie jak ChatGPT czy Perplexity korzystają z mechanizmu RAG (Retrieval-Augmented Generation): pobierają fragmenty zewnętrznych źródeł i wplatają je w odpowiedź. Żeby Twoja strona mogła być takim źródłem, musi być po pierwsze dostępna technicznie, a po drugie napisana tak, by dało się z niej wyciągnąć konkretną, samodzielną odpowiedź. Więcej o tym, jak działa RAG, w osobnym artykule.
Czego to uczy o Twojej stronie
Nie trzeba być agencją AI, żeby mieć ten problem: wystarczy, że Twoja strona powstała w ostatnich latach w popularnym narzędziu no-code albo we frameworku bez SSR.
Webflow w trybie JS-heavy, Framer, własny build w React bez renderowania serwerowego: wszystkie mogą generować strony niewidoczne dla crawlerów AI. Trzy pytania, które warto zadać sobie już dziś:
- Czy widzę swoją treść w źródle strony? Otwórz Ctrl+U na stronie głównej. Jeśli nie widzisz tam swojego tekstu, masz problem. Najszybszy test z linii poleceń to jedna komenda:
curl -A "Mozilla/5.0" https://twojadomena.pl, zobaczysz surowy HTML dokładnie taki, jaki dostaje bot. - Czy mam dane strukturalne? Wejdź na Rich Results Test i sprawdź swoją domenę. Brak wyników = schema nie istnieje lub jest błędna.
- Czy moja strona odpowiada na konkretne pytania? AI cytuje strony, które odpowiadają. Jeśli Twoja mówi tylko „jesteśmy liderem rynku" zamiast „pomagamy firmom X osiągnąć Y dzięki Z", nie ma czego cytować.
U nas, przy pełnej przebudowie i nauce w trakcie, zajęło to około trzech tygodni. Z gotowym procesem robi się to szybciej, ale najpierw trzeba zdiagnozować, gdzie dokładnie leży problem. Najczęstsze błędy i ich naprawy zebraliśmy w: 7 najczęstszych błędów blokujących widoczność w AI.
FAQ
Czy każda strona w React jest niewidzialna dla AI?
Nie każda. Strony w React z włączonym SSR (renderowanie po stronie serwera) lub generowaniem statycznym (SSG, np. Next.js) wysyłają do crawlera gotowy HTML z treścią. Problem dotyczy wyłącznie aplikacji React renderowanych po stronie klienta, gdzie serwer wysyła pusty HTML, a treść buduje JavaScript w przeglądarce.
Czy muszę migrować na statyczny HTML?
Niekoniecznie. Statyczny HTML to najprostsze i najpewniejsze rozwiązanie dla stron marketingowych, ale nie jedyne. Jeśli zależy Ci na frameworku, poprawnie skonfigurowany SSR lub SSG (Next.js, Nuxt, Astro) też rozwiązuje problem. Pytanie brzmi: czy złożoność frameworka jest uzasadniona dla strony, która ma kilkanaście podstron i zmienia się raz na kwartał.
Czy SSR rozwiązuje problem?
Tak, o ile jest poprawnie skonfigurowany. SSR sprawia, że serwer generuje pełny HTML przed wysłaniem go do przeglądarki: crawler dostaje gotową treść bez uruchamiania JavaScriptu. Warto sprawdzić, czy SSR rzeczywiście działa, a nie jest tylko zainstalowany. Test: Ctrl+U i szukanie treści w źródle.
Czy to samo dotyczy stron na WordPressie?
Standardowy WordPress generuje HTML po stronie serwera, więc crawlery AI nie mają z nim problemu technicznego. Kłopot pojawia się przy page-builderach z dużą ilością JavaScriptu (np. niektóre konfiguracje Elementora) lub motywach opartych na React / headless WordPress. W razie wątpliwości wróć do testu źródła strony.
Jak sprawdzić, czy moja strona renderuje się bez JavaScriptu?
Najprościej z linii poleceń: curl -A "Mozilla/5.0" https://twojadomena.pl, zwróci surowy HTML, jaki dostaje bot przy pierwszym pobraniu.
W przeglądarce: Chrome → DevTools (F12) → otwórz Command Menu (Ctrl+Shift+P lub Cmd+Shift+P), wpisz „Disable JavaScript", zatwierdź i odśwież stronę. Jeśli zobaczysz pustą kartę lub sam szkielet bez treści, crawler AI widzi dokładnie to samo.